ความเห็นการปรับปรุงระบบของ TCI
คุณชาตรี วงศ์แก้ว นักวิจัยจากศูนย์ดัชนีการอ้างอิงวารสารไทย – TCI: Thailand Citation Index ได้ติดต่อมาเพื่อขอความรู้ในประเด็นแนวทางการพัฒนาปรับปรุงระบบเว็บและฐานข้อมูลของ TCI
ประเด็นหลักๆ คือศูนย์ดัชนีการอ้างอิงวารสารไทย ได้ดำเนินการจัดทำระบบฐานข้อมูลดัชนีการอ้างอิงวารสารไทยมาครบ 10 ปี รวมทั้งกำลังดำเนินการพัฒนาฐานข้อมูลดัชนีการอ้างอิงวารสารอาเซียน แต่การทำงานของระบบโดยเฉพาะการนำเข้าข้อมูลยังเป็นระบบพิมพ์มือ ซึ่งผู้ที่เกี่ยวข้องทุกส่วนของศูนย์ฯ ต้องการให้มีการปรับปรุงกระบวนการนำเข้า
การทำงานของฐานข้อมูลดัชนีการอ้างอิงวารสารไทยและอาเซียน
- หน่วยงานที่ทำหน้าที่เป็นกองบรรณาธิการวารสารในประเทศไทย ส่งข้อมูลวารสาร เช่น ชื่อวารสาร สาขาที่เกี่ยวข้อง หน่วยงานที่รับผิดชอบ สังกัด กองบรรณาธิการ ISSN ข้อมูลและรูปแบบการเผยแพร่ ให้ TCI เพื่อทีมงานของ TCI นำไปป้อนข้อมูลเข้าสู่ระบบ
- ทุกรอบการเผยแพร่วารสาร กองบรรณาธิการ จะต้องส่งวารสารจะเป็นรูปแบบตัวเล่ม หรือรูปแบบสิ่งพิมพ์อิเล็กทรอนิกส์ก็ได ให้ทีมงาน TCI และทีมงาน TCI จะดำเนินการ
- ป้อนข้อมูลเกี่ยวกับ “บทความ” ในวารสาร เข้าสู่ระบบ เช่น ชื่อบทความ ผู้แต่ง สังกัด บทคัดย่อ
- ป้อนข้อมูลการอ้างอิงของบทความ ในวารสารเข้าสู่ระบบ
- เมื่อข้อมูลวารสาร ข้อมูลบทความ และข้อมูลการอ้างอิงได้ถูกป้อนข้อมูลระบบ ทีมงานจะดำเนินการนำข้อมูลการอ้างอิงไปเปรียบเทียบกับข้อมูลบทความที่มีอยู่ในระบบ เพื่อหาว่าบทความใดถูกอ้างอิงผ่านบทความใด จำนวนกี่ครั้ง
ทั้งนี้การทำงานเกือบทุกขั้นตอนเป็นการทำงานแบบป้อนมือ และประมวลผลแบบมือ ประเด็นที่ต้องการมาปรึกษาคือ มีแนวทางปรับปรุงกระบวนการได้อย่างไร และต้องดำเนินการประการใดเพิ่มเติมเพื่อบริการผู้ใช้ให้มากขึ้นหลักการของสาขาบรรณารักษ์และสารสนเทศศาสตร์
การป้อนข้อมูลวารสาร ยังเป็นการดำเนินการที่ค่อนข้างยาก เพราะตามหลักตัวเลขประจำวารสารคือ ISSN ควรเป็นส่วนสำคัญในการป้อน คือ การป้อนข้อมูลวารสารควรเริ่มจากการป้อนเลข ISSN เข้าระบบ แล้วระบบก็นำ ISSN ไปตรวจสอบข้อมูลผ่านฐานข้อมูลบรรณานุกรมแห่งชาติ ที่หอสมุดแห่งชาติ แล้วระบบก็ดึงค่าข้อมูลที่เกี่ยวข้องมาเติมอัตโนมัติที่ระบบของ TCI ดังตัวอย่างระบบสืบค้น ISSN ของ CrossRef
แต่เนื่องจากประเทศไทย ยังไม่มี “ฐานข้อมูลบรรณานุกรมแห่งชาติ” จึงยังไม่สามารถใช้แนวทางนี้ได้ ซึ่งได้แนะนำให้ TCI ประสานกับหอสมุดแห่งชาติ เร่งดำเนินการพัฒนาฐานข้อมูลบรรณานุกรมแห่งชาติเพื่อบริการต่อไป และปรับความสามารถนำเข้าข้อมูลของระบบ TCI ด้วยความสามารถ ISSN Lookup
วิธีที่สอง คือ การนำเข้าผ่าน BibTeX ไฟล์โครงสร้างในฟอร์แมต LaTeX ที่ระบบห้องสมุดอัตโนมัติที่มีมาตรฐานกำหนดไว้ในระบบ ดังนั้นเมื่อ TCI ได้รับตัวเล่มวารสารใหม่ ก็เริ่มจากการนำชื่อวารสารไปสืบค้นผ่านระบบห้องสมุดอัตโนมัติที่มีมาตรฐานของสถาบันการศึกษาชั้นนำ เช่น ระบบห้องสมุดอัตโนมัติของหอสมุดจอห์น เอฟ เคนเนดี้ สำนักวิทยบริการ มหาวิทยาลัยสงขลานครินทร์ ซึ่งบรรณารักษ์จะนำข้อมูลวารสารไปลงรายการ และเมื่อได้ผลลัพธ์ที่ต้องการ ก็สามารถนำข้อมูลบรรณานุกรมจากระบบห้องสมุดอัตโนมัติดังกล่าวส่งออกในฟอร์แมต BibTeX
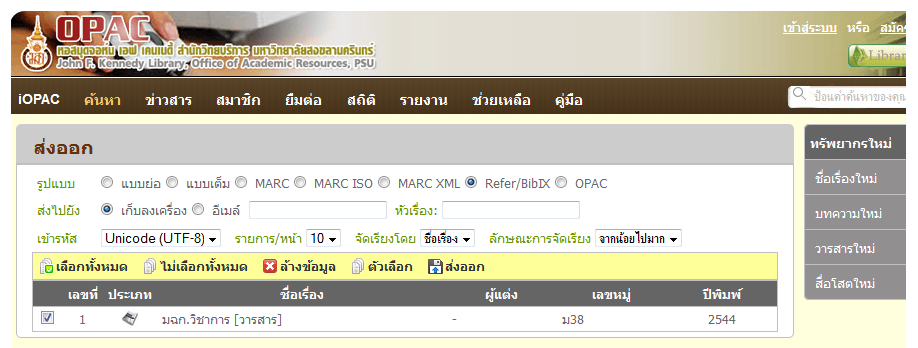
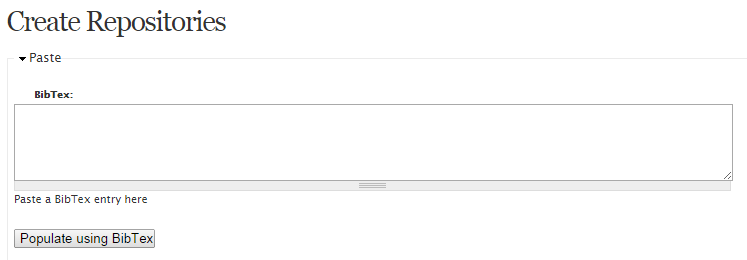
อย่างไรก็ดี ในทางปฏิบัติวิธีนี้ก็ยังคงมีปัญหา เพราะการลงรายการบรรณานุกรมทรัพยากรของห้องสมุดต่างๆ มีแนวปฏิบัติที่ไม่ไปในทางเดียวกัน ไม่ว่าจะเป็นการให้ชื่อเรื่อง หัวเรื่อง เลขหมู่ การพิมพ์ชื่อนามสกุลของผู้แต่ง สังกัด ฯลฯ อันจะส่งต่อข้อมูลที่ได้ ดังนั้น TCI ควรดำเนินการต่อเนื่องในวิธีแรกคือ เร่งประสานกับหอสมุดแห่งชาติ พัฒนาและเปิดใช้งาน “ฐานข้อมูลบรรณานุกรมแห่งชาติ” พร้อมฟังก์ชันเชื่อมต่อข้อมูลอัตโนมัติ โดยเร็ว รวมทั้งปรับปรุงความสามารถนำเข้าข้อมูลของระบบ TCI ให้สนับสนุนการนำเข้าไฟล์ BibTeX ทั้งแบบ Import และ BibTeX Paste
การป้อนข้อมูลบทความ
หัวใจสำคัญของระบบดัชนีการอ้างอิงวารสารไทยและอาเซียน จะอยู่ที่ข้อมูลบทความ และข้อมูลการอ้างอิงของบทความนั้นๆ ซึ่งการป้อนข้อมูลส่วนนี้จะมีปริมาณมาก และต้องการความถูกต้อง ความรวดเร็ว เพื่อนำข้อมูลไปประมวลผลหาค่า Impact Factor
ในส่วนการป้อนข้อมูลบทความ สามารถทำได้หลายวิธี โดยประสานกับศูนย์ DOI – Digital Object Identifier ของ วช. ในการออก DOI ให้กับบทความแต่ละบทความ จากนั้น TCI ก็จะนำ DOI ดังกล่าวมาใช้ป้อนเข้าระบบ ซึ่งระบบจะนำ DOI ไปตรวจสอบกับฐานข้อมูล DOI วช. และดึงข้อมูลของบทความมาเติมระบบโดยอัตโนมัติ รวมทั้งทีม TCI ควรจะตกลงกระบวนการลงรายการในฝั่ง DOI ให้สอดคล้องกับ TCI เพื่อให้ข้อมูลไหลได้ถูกต้อง นอกจาก DOI บทความในวารสารทางการแพทย์ ยังมีการใช้ PubMed ID ดังนั้นระบบของ TCI ควรรองรับทั้ง DOI Lookup และ PubMed Lookup
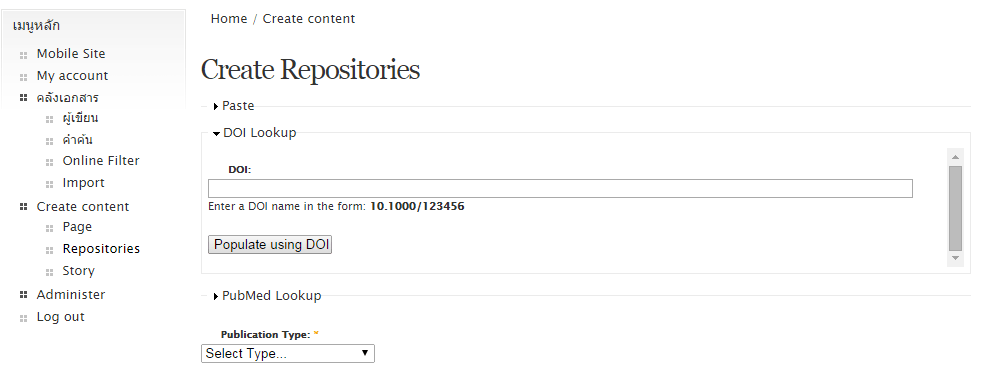
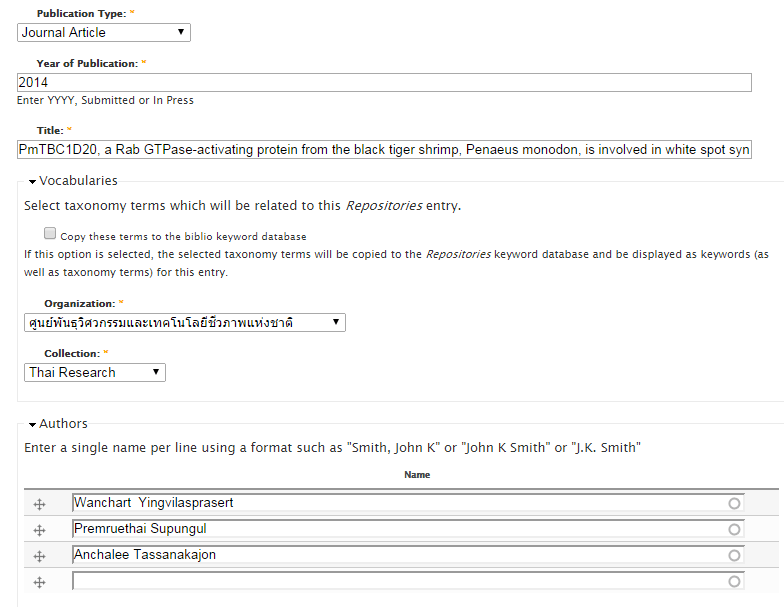
วิธีที่สอง สืบเนื่องจาก TCI ได้เลือกใช้ Open Source Software ในกลุ่ม Journal Management ชื่อ Open Journal System : OJS ในการส่งเสริมให้วารสารต่างๆ นำวารสารและบทความมาเผยแพร่ออนไลน์ผ่านเว็บที่เรียกว่า ThaiJo ทีม TCI จึงควรเปิดฟังก์ชันของ OJS ให้ครบถ้วน โดยเฉพาะฟังก์ชัน OpenURL, BibTeX เพื่อใช้ประโยชน์จาก OJS ในการส่งออกบรรณานุกรมของวารสารในรูปแบบ OpenURL หรือรูปแบบ BibTeX
อย่างไรก็ดีการนำเข้าข้อมูลวารสารและบทความใน ThaiJo ยังเป็นเอกสาร PDF แบบสแกนเป็นส่วนใหญ่ และไม่เคยตกลงในประเด็นการให้ข้อมูล ส่งผลให้ข้อมูลที่ส่งผ่าน OpenURL และ BibTeX ไม่ถูกต้อง TCI จึงควรศึกษาฟังก์ชัน OSJ และกำหนดแนวปฏิบัติการนำข้อมูลเข้า ThaiJo แทนที่การปล่อยให้กองบรรณาธิการนำเข้าและลงรายการแบบที่เป็นอยู่
วิธีอื่นๆ ที่สามารถดำเนินการได้ คือ TCI กำหนดฟอร์แมตของ QR Code พร้อมเครื่องมือสร้าง และให้กองบรรณานุกรมมาลงทะเบียนพร้อมสร้าง QR Code ติดทุกวารสาร ทุกบทความ เพื่อให้ทีม TCI สามารถใช้เครื่องอ่าน QR Code ป้อนข้อมูลลงฟิลด์ต่างๆ ได้สะดวกขึ้น
การป้อนข้อมูลการอ้างอิง
ข้อมูลการอ้างอิงของบทความแต่ละบทความเป็นส่วนสำคัญส่วนหนึ่งที่ TCI สนใจ ทั้งนี้วิธีการนำเข้าที่เสนอความเห็นคือ การประสานให้กองบรรณาธิการส่งไฟล์ Bib ที่ได้จากโปรแกรม Reference Manager เช่น EndNote หรือ Zotero เนื่องจากสถาบันการศึกษาส่วนมากได้ซื้อโปรแกรม EndNote มาให้บริการ และนักศึกษา นักวิจัย นักวิชาการก็ใช้ EndNote ในการเก็บบรรณานุกรมของเอกสารที่ใช้ประกอบการเขียนผลงาน เพื่อนำมาทำอ้างอิงและรายการอ้างอิงท้ายเล่มในรายงาน แต่กลับละเลยไฟล์ Bib
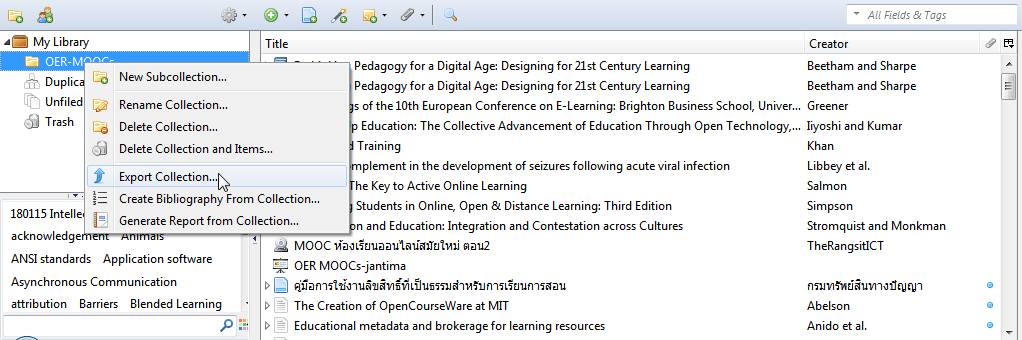
หาก TCI สามารถประสานขอให้กองบรรณานุกรมส่งตัวเล่มหรือไฟล์เอกสารพร้อมแนบไฟล์ Bib ของแต่ละบทความ พร้อมพัฒนาฟังก์ชันนำเข้า ย่อมทำให้การนำเข้ารายการอ้างอิงแต่ละบทความเป็นไปโดยสะดวกมากขึ้น
นอกจากนี้อาจจะประสานกับหน่วยวิจัยของ NECTEC ในการนำ OCR และ PDF Extraction มาผสานกับระบบของ TCI โดยทำหน้าที่แปลงข้อความในหน้ารายการอ้างอิงท้ายบทความ แล้วป้อนลงระบบอัตโนมัติ อย่างไรก็ดีการใช้วิธีนี้ยังมีประเด็นที่ TCI ควรให้ความสำคัญเป็นพิเศษ ดังนี้
TCI ควรกำหนดแนวปฏิบัติการทำรายการอ้างอิงให้สอดคล้องกับ Machine Readable ให้สถาบันการศึกษาและหน่วยงานต่างๆ ปฏิบัติตาม เพราะยังมีหลายสถาบันการศึกษาและหลายหน่วยงาน ยึดการทำรายการอ้างอิงบนฐานเครื่องพิมพ์ดีด เช่น หากมีชื่อผู้แต่งซ้ำในรายการถัดไป ให้พิมพ์ด้วย _________ รวมทั้งการขึ้นบรรทัดกรณีที่รายการอ้างอิงหนึ่งยาวเกิน 1 บรรทัด ที่ควรให้แนวปฏิบัติที่ถูกต้องด้วยการใช้ความสามารถ Hanging Indent แทนการกดปุ่ม Enter หรือการเคาะวรรค ซึ่งหากยังคงมีการทำรายการอ้างอิงแบบเดิม จะทำให้การประมวลผลผิดพลาด หรือล่าช้าได้
นอกจากนี้เอกสาร PDF แบบสแกนที่มีอยู่ในปัจจุบันยังผ่านกระบวนการสแกนที่ไม่ได้มาตรฐาน ตั้งแต่การกำหนดความละเอียดของงาน การวางกระดาษ รวมถึงเอกสาร PDF แบบ Convert ก็ยังไม่ได้กำหนดฟอนต์มาตรฐานร่วมกันระหว่างหน่วยงาน แนวทางการแปลงดิจิทัลเอกสาร ซึ่งจะส่งผลให้กระบวนการ Extraction เกิดข้อผิดพลาดได้
อีกส่วนที่สำคัญคือ TCI ควรดำเนินการปรับปรุงคือ ฐานข้อมูลผู้แต่ง เนื่องจากผู้แต่งอาจจะมีการเปลี่ยนชื่อ นามสกุล รวมทั้งการนำเข้าข้อมูลการอ้างอิงด้วยวิธีอัตโนมัติ อาจจะได้ข้อมูลผู้แต่งไม่ทราบ อันเนื่องจากข้อกำหนดของการอ้างอิง (Citation Style) เช่น ระบุให้พิมพ์นามสกุลของผู้แต่งด้วยตัวพิมพ์ใหญ่ตัวแรกแล้วตามด้วย ดังนั้นฐานข้อมูลผู้แต่งจะช่วยให้สามารถป้อนรายละเอียด โดยฟังก์ชันสำคัญของฐานข้อมูลนี้คือ Author Merge โดยนำชื่อรูปแบบต่างๆ ของผู้แต่งคนเดียวกันมาผสานเป็นชื่อเดียว
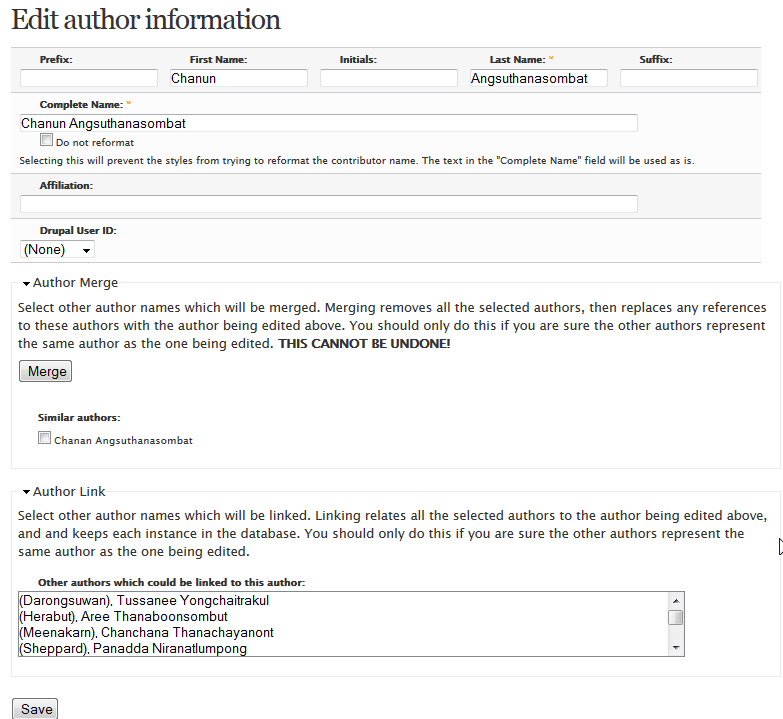
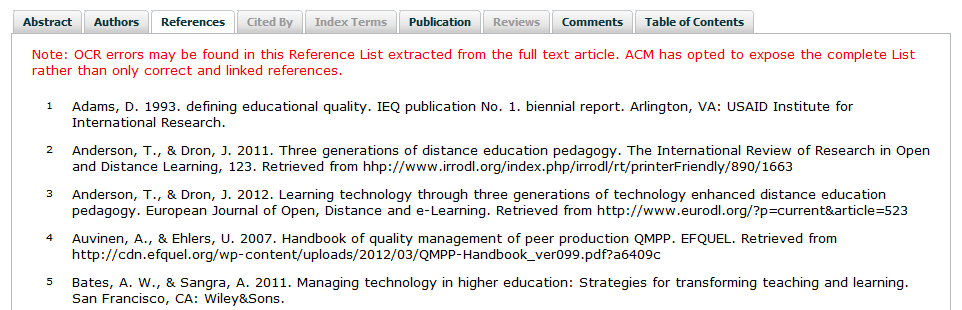
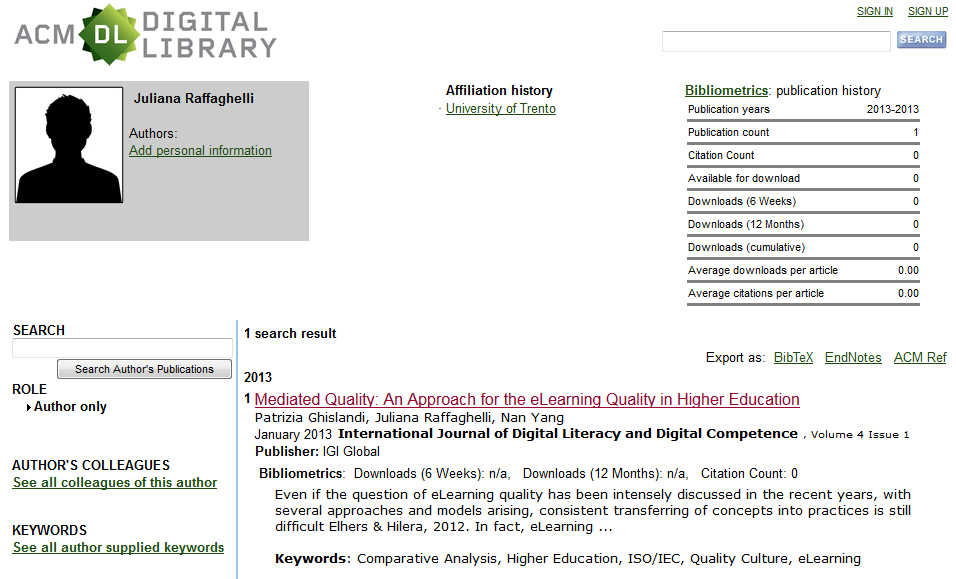
รวมทั้งการนำข้อมูลรายการอ้างอิงมา Map กับชื่อบทความอื่นๆ ในวารสาร พร้อมประมวลผลค่าการอ้างอิงแบบอัตโนมัติแทนการนับด้วยมือ โดยดูตัวอย่างจากระบบ ACM Digital Library ในส่วน Reference และ Cited by
การประมวลผลสถิติของผู้แต่งแต่ละบุคคล ดังความสามารถ Bibliometric ของ ACM Digital Library

You must be logged in to post a comment.